


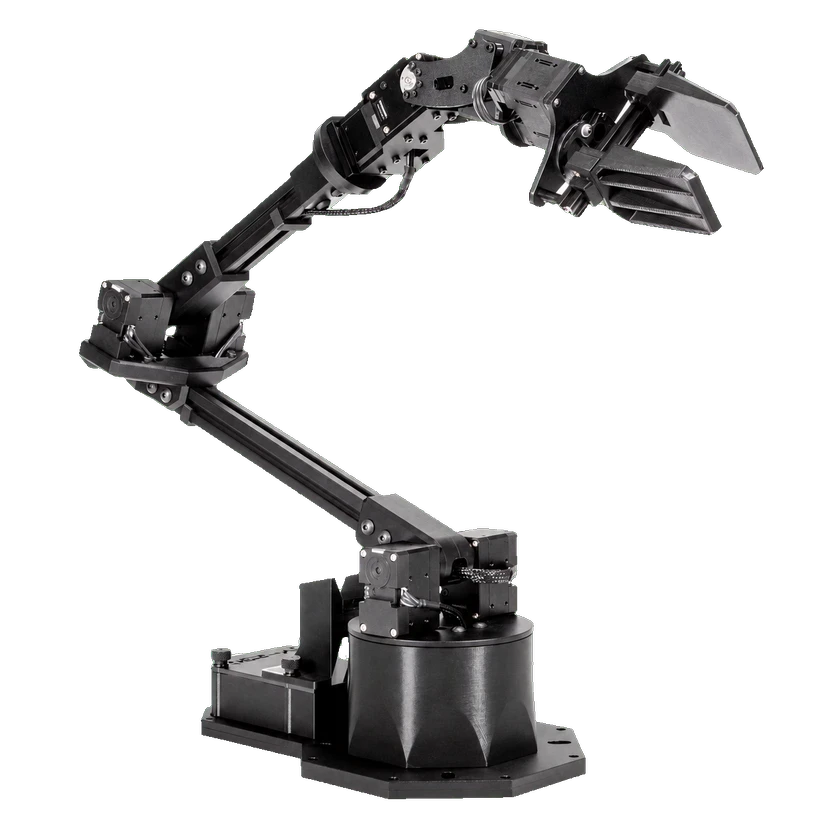
机械臂
WidowX-250 6DOF
VLA-JEPA ↗软件适配
VLA-JEPA 官方材料提供了用于 WidowX 评估任务的 SimplerEnv 检查点。 · BridgeData V2 明确该研究平台为 WidowX-250 6DOF。
需使用文档所述 SimplerEnv 环境和 VLA-JEPA-Simpler 检查点。
适用于 BridgeData V2。
VLA-JEPA 是视觉语言动作预训练框架,通过预测未来潜在状态学习动作相关动态,再微调动作头。论文作者来自中国科学技术大学、中关村学院、上海交通大学、清华大学、宁波东方理工大学、中国科学院大学与南开大学。
产品型号: 1 · 版本关系: 1
实验不代表出厂配置;证据仅适用于明确列出的模型版本。
机械臂
VLA-JEPA 官方材料提供了用于 WidowX 评估任务的 SimplerEnv 检查点。 · BridgeData V2 明确该研究平台为 WidowX-250 6DOF。
需使用文档所述 SimplerEnv 环境和 VLA-JEPA-Simpler 检查点。
适用于 BridgeData V2。
2月10日首版论文提出VLA-JEPA:未来帧仅用于目标编码的JEPA式潜在未来状态监督,随后适配动作头用于机器人控制,提供新的模型/训练框架选择。归档日期不等于已核实的首次代码/权重开放日,当前原生和转换文件另行记录。
本次公开变化
2月10日首版论文提出VLA-JEPA:未来帧仅用于目标编码的JEPA式潜在未来状态监督,随后适配动作头用于机器人控制,提供新的模型/训练框架选择。归档日期不等于已核实的首次代码/权重开放日,当前原生和转换文件另行记录。
重点理由:面向动作的潜世界模型训练架构实质影响选型和适配;不因本站补录、论文修订或所谓全面涨分设重点,人类视频收益有取舍。
有论文
VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model
署名方式: 原文顺序
Hugging Face LeRobot · 文档
发布日期未知 · 访问于: 2026-07-24
VLA-JEPA authors / ginwind · 代码仓库
发布日期未知 · 访问于: 2026-11-07
VLA-JEPA authors / ginwind · 来源
发布日期未知 · 访问于: 2026-11-07
VLA-JEPA authors / ginwind · 研究论文
发布于: 2026-02-14 · 访问于: 2026-11-07
VLA-JEPA authors · 官方网站
发布日期未知 · 访问于: 2026-10-27
VLA-JEPA authors / ginwind · 代码仓库
发布日期未知 · 访问于: 2026-11-07