


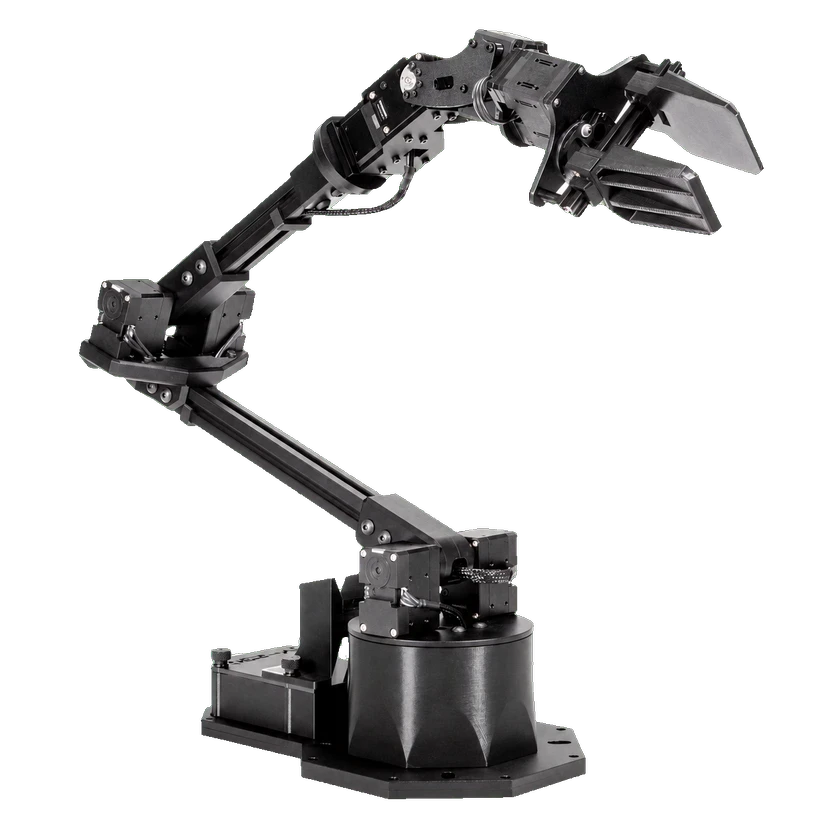
로봇 팔
WidowX-250 6DOF
VLA-JEPA ↗소프트웨어 통합
VLA-JEPA 공식 자료는 WidowX 평가 작업용 SimplerEnv 체크포인트를 제공합니다. · BridgeData V2는 연구 플랫폼을 WidowX-250 6DOF로 명시합니다.
문서화된 SimplerEnv 환경과 VLA-JEPA-Simpler 체크포인트가 필요합니다.
BridgeData V2에 적용됩니다.
VLA-JEPA는 미래 잠재 상태를 예측해 행동 관련 동역학을 학습한 뒤 행동 헤드를 미세 조정하는 시각·언어·행동 사전학습 프레임워크다. 논문 저자는 중국과학기술대, 중관춘학원, 상하이교통대, 칭화대, 닝보동방이공대, 중국과학원대, 난카이대 소속이다.
로봇 모델: 1 · 버전 관계: 1
실험은 기본 탑재를 의미하지 않습니다. 근거는 명시된 모델 버전에만 적용됩니다.
로봇 팔
VLA-JEPA 공식 자료는 WidowX 평가 작업용 SimplerEnv 체크포인트를 제공합니다. · BridgeData V2는 연구 플랫폼을 WidowX-250 6DOF로 명시합니다.
문서화된 SimplerEnv 환경과 VLA-JEPA-Simpler 체크포인트가 필요합니다.
BridgeData V2에 적용됩니다.
2월 10일 최초 논문은 JEPA 방식의 잠재 미래 상태 학습과 로봇 제어용 행동 헤드 적응을 소개합니다. 미래 프레임은 목표 인코딩에만 사용됩니다. 사람 영상과 행동 라벨이 있는 로봇 데이터를 결합하는 모델·학습 선택지가 추가되었습니다. 최초 코드 또는 가중치 개방일은 확인되지 않았습니다.
이번 발표
2월 10일 최초 논문은 JEPA 방식의 잠재 미래 상태 학습과 로봇 제어용 행동 헤드 적응을 소개합니다. 미래 프레임은 목표 인코딩에만 사용됩니다. 사람 영상과 행동 라벨이 있는 로봇 데이터를 결합하는 모델·학습 선택지가 추가되었습니다. 최초 코드 또는 가중치 개방일은 확인되지 않았습니다.
사람 영상의 학습 신호를 활용하는 새로운 학습 체계가 모델 선택과 적응에 실질적인 선택지를 추가하므로 중요합니다. 보편적인 벤치마크 우위를 뜻하지 않으며 사람 영상 효과는 혼합되어 있습니다.
논문 있음
VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model
저자 순서: 원문 순서
Hugging Face LeRobot · 문서
발행일 알 수 없음 · 접근일: 2026-07-24
VLA-JEPA authors / ginwind · 코드 저장소
발행일 알 수 없음 · 접근일: 2026-11-07
VLA-JEPA authors / ginwind · 출처
발행일 알 수 없음 · 접근일: 2026-11-07
VLA-JEPA authors / ginwind · 연구 논문
발행일: 2026-02-14 · 접근일: 2026-11-07
VLA-JEPA authors · 공식 웹사이트
발행일 알 수 없음 · 접근일: 2026-10-27
VLA-JEPA authors / ginwind · 코드 저장소
발행일 알 수 없음 · 접근일: 2026-11-07