


ロボットアーム
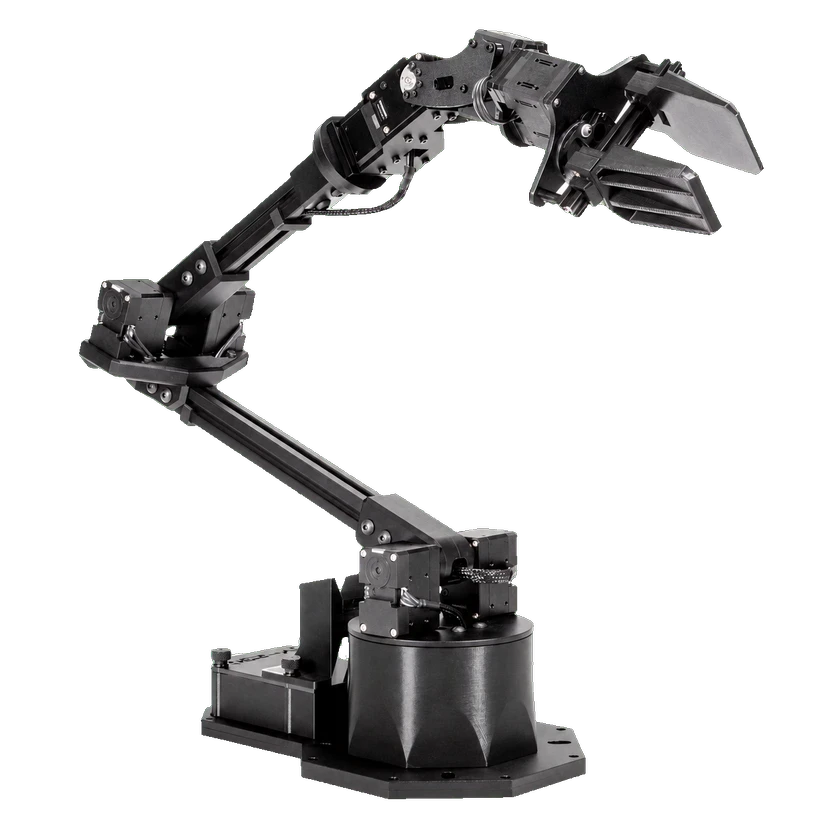
WidowX-250 6DOF
VLA-JEPA ↗ソフトウェア統合
VLA-JEPA 公式資料は WidowX 評価タスク用の SimplerEnv チェックポイントを提供しています。 · BridgeData V2 は研究プラットフォームを WidowX-250 6DOF と明記しています。
文書化された SimplerEnv 環境と VLA-JEPA-Simpler チェックポイントが必要です。
BridgeData V2 に適用されます。
VLA-JEPAは将来の潜在状態の予測で行動に関わる動態を学び、行動ヘッドを微調整する視覚言語行動の事前学習フレームワーク。論文著者は中国科学技術大学、中関村学院、上海交通大学、清華大学、寧波東方理工大学、中国科学院大学、南開大学に所属する。
ロボット型式: 1 · バージョン関係: 1
実験は標準搭載を意味しません。根拠は記載されたモデルバージョンにのみ適用されます。
ロボットアーム
VLA-JEPA 公式資料は WidowX 評価タスク用の SimplerEnv チェックポイントを提供しています。 · BridgeData V2 は研究プラットフォームを WidowX-250 6DOF と明記しています。
文書化された SimplerEnv 環境と VLA-JEPA-Simpler チェックポイントが必要です。
BridgeData V2 に適用されます。
2月10日初論文は未来フレームを教師符号化に限定したJEPA潜在状態学習と動作ヘッド適応を発表。新モデル/学習枠組みの選択肢で、同日の初コード/重み公開は未確認。現原生/変換重みは別途記録。
今回の発表
2月10日初論文は未来フレームを教師符号化に限定したJEPA潜在状態学習と動作ヘッド適応を発表。新モデル/学習枠組みの選択肢で、同日の初コード/重み公開は未確認。現原生/変換重みは別途記録。
重点理由:動作関連潜在世界学習は選択/適応を実質変更。サイト追記/論文改訂/全面向上が理由ではなく人間動画効果は混合。
論文あり
VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model
著者の順序: 原文順
Hugging Face LeRobot · ドキュメント
公開日不明 · 参照日: 2026-07-24
VLA-JEPA authors / ginwind · コードリポジトリ
公開日不明 · 参照日: 2026-11-07
VLA-JEPA authors / ginwind · 出典
公開日不明 · 参照日: 2026-11-07
VLA-JEPA authors / ginwind · 研究論文
公開日: 2026-02-14 · 参照日: 2026-11-07
VLA-JEPA authors · 公式サイト
公開日不明 · 参照日: 2026-10-27
VLA-JEPA authors / ginwind · コードリポジトリ
公開日不明 · 参照日: 2026-11-07