VLA-JEPA ist ein Vortrainingsverfahren für Vision-Language-Action-Modelle. Es lernt handlungsrelevante Dynamik durch Vorhersage zukünftiger latenter Zustände; danach wird der Aktionskopf feinabgestimmt. Die Autoren gehören USTC, Zhongguancun-Akademie, SJTU, Tsinghua, EIT Ningbo, UCAS und Nankai an.
Grundinformationen
Modelltyp
Aktionspolicy
Erfasste Versionen
VLA-JEPA
Erste Vorstellung der Reihe
Verwandte Roboter
1
Verwandte Roboter
Robotermodelle: 1 · Versionsbeziehungen: 1
Versuche bedeuten keine Serienausstattung. Belege gelten nur für die genannte Modellversion.
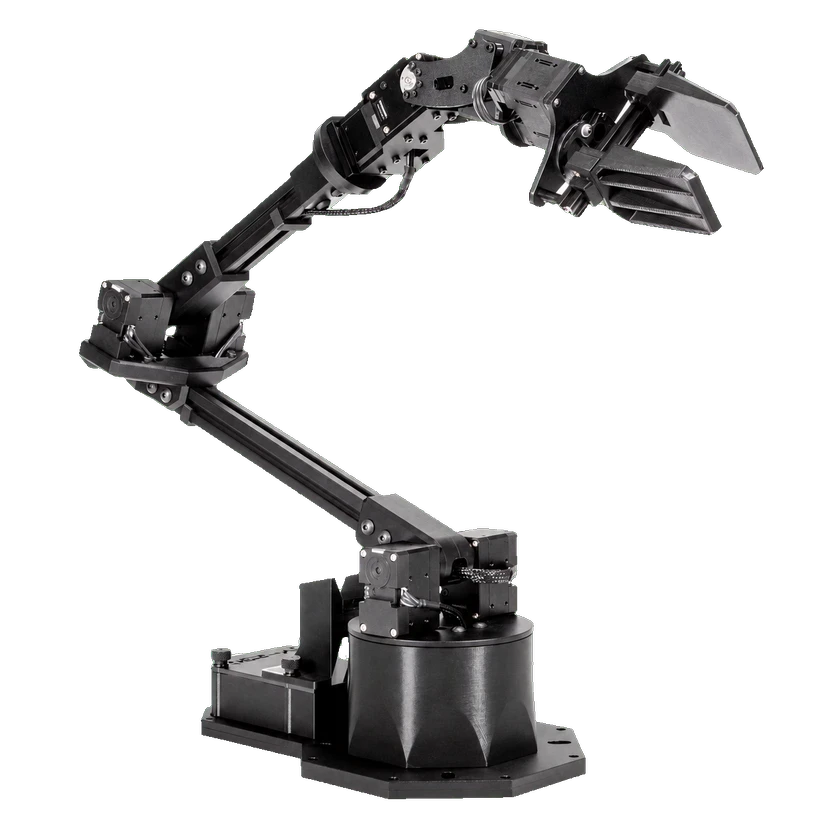
Offizielle VLA-JEPA-Materialien stellen einen SimplerEnv-Checkpoint für eine WidowX-Evaluierungsaufgabe bereit. · BridgeData V2 identifiziert die Forschungsplattform als WidowX-250 6DOF.
Erfordert die dokumentierte SimplerEnv-Umgebung und den VLA-JEPA-Simpler-Checkpoint.
Das erste Paper vom 10. Februar stellt JEPA-basiertes Lernen latenter Zukunftszustände mit anschließender Anpassung des Aktionskopfs für Robotersteuerung vor. Zukunftsframes dienen nur der Zielcodierung. Dies ergänzt die Modell- und Trainingsauswahl um die Kombination menschlicher Videos mit aktionsbeschrifteten Roboterdaten. Das Datum der ersten Code- oder Gewichtsfreigabe ist nicht belegt.
Aktuelle Bekanntgabe
Das erste Paper vom 10. Februar stellt JEPA-basiertes Lernen latenter Zukunftszustände mit anschließender Anpassung des Aktionskopfs für Robotersteuerung vor. Zukunftsframes dienen nur der Zielcodierung. Dies ergänzt die Modell- und Trainingsauswahl um die Kombination menschlicher Videos mit aktionsbeschrifteten Roboterdaten. Das Datum der ersten Code- oder Gewichtsfreigabe ist nicht belegt.
Wichtig, weil das neu vorgestellte Trainingsverfahren mit menschlichen Videos eine praktische Option für Modellauswahl und Anpassung ergänzt. Daraus folgt keine universelle Benchmarküberlegenheit; die berichteten Effekte menschlicher Videos sind gemischt.