
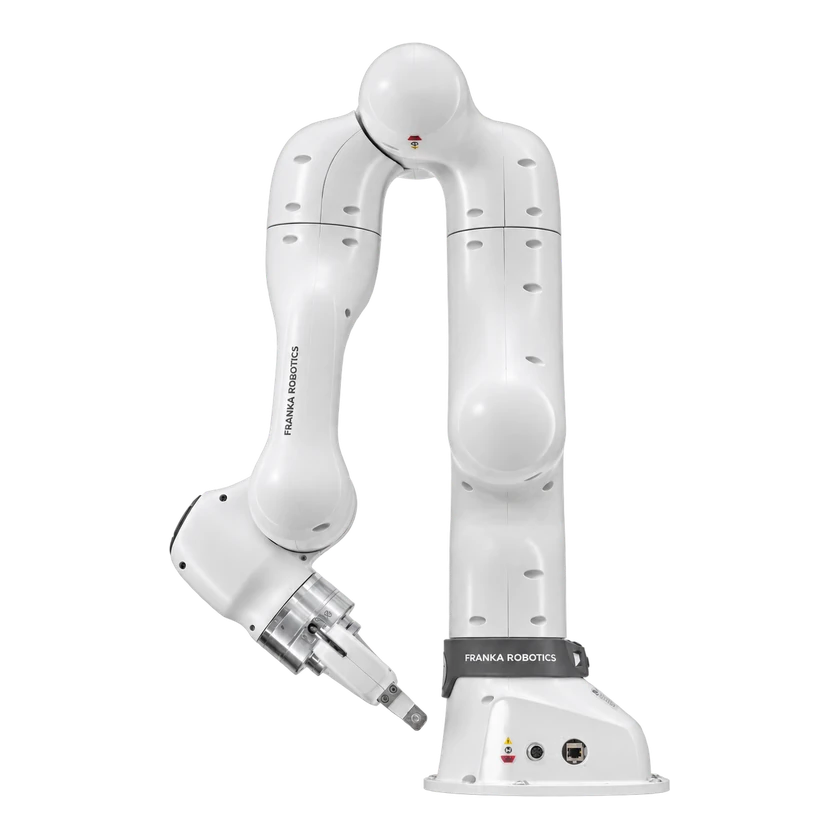
ロボットアーム
華南理工大学によるロボット操作方策の階層型事前学習手法。人の操作動画を用いて、3D教師モデルとの特徴整合、深度再構成、手領域への注意誘導、将来の3D手首軌跡の予測を学習する。3種類のシミュレーションと Franka Research 3 実機で評価された。
ロボット型式: 1 · バージョン関係: 1
実験は標準搭載を意味しません。根拠は記載されたモデルバージョンにのみ適用されます。
ロボットアーム
論文あり
Lift, See, Act: Hierarchical Robot Policy Pretraining with 3D Foundation Models
著者の順序: 原文順
LSA pretraining method, simulation and real-robot experiments
タイトル未登録
LSA authors · 研究論文
公開日: 2026-11-16 · 参照日: 2026-11-21
タイトル未登録
LSA authors · 公式サイト
公開日不明 · 参照日: 2026-11-21
タイトル未登録
Apple · コードリポジトリ
公開日不明 · 参照日: 2026-11-21
タイトル未登録
Meta FAIR · モデルカード
公開日不明 · 参照日: 2026-11-21
タイトル未登録
LSA authors · コードリポジトリ
公開日不明 · 参照日: 2026-11-21